
Opzet van beheersmaatregelen beoordelen met AI
Automatisering in auditwerk is geen nieuws. Wat auditors kunnen tellen, wordt al jaren geteld: transacties, logregels en uitzonderingen. Waar vroeger een deelwaarneming werd toegepast, zijn auditors tegenwoordig steeds meer in staat een uitspraak te doen over de volledige populatie.
Die automatisering wordt in de praktijk voor een specifiek doel ingezet. Ze toetst of een beheersmaatregel heeft gewerkt, niet of de opzet van de beheersmaatregel klopt. Het eerste draait om data, het tweede om taal: iemand leest een beschrijving en beslist of de beheersmaatregel het criterium of risico werkelijk afdekt. Het gevaar is dat de auditor concludeert dat maatregelen effectief hebben gewerkt, zonder goed te hebben beoordeeld of de juiste set van beheersmaatregelen is toegepast. Ook onderzoek naar AI in de accountancy volgde die lijn en ging vooral over cijfers en afwijkingen. Over de opzettoets ging het nauwelijks, terwijl dat juist het werk is waarbij twee ervaren collega’s tot verschillende conclusies kunnen komen.
AI als hulpmiddel voor de auditor
AI is een relatief nieuw gereedschap dat een auditor hierbij kan ondersteunen. Dat AI inmiddels op grote schaal in de beroepspraktijk wordt uitgerold, bewijst nog niet dat het hiervoor ook wordt ingezet of dat het deugt. In het kader van mijn opleiding, het Executive Program of Digital Auditing aan de Universiteit van Amsterdam, onderzocht ik daarom in hoeverre AI auditors kan helpen bij het beoordelen van de opzet van beheersmaatregelen. ChatGPT beoordeelde ruim negenduizend keer de opzet van beheersmaatregelen in één SOC 2 type 2-rapport: alle 56 basiscriteria die de standaard bevat, telkens opnieuw, met een vast beoordelingskader en zonder dat het model iets anders mocht zien dan de gedocumenteerde tekst. Wat het model als tekortkoming aanmerkte, is daarna voorgelegd aan een panel van vier auditors.
Wat de opzettoets lastig maakt
Opzet komt vóór bestaan en werking en is bepalend voor het vervolg. Een beheersmaatregel die het criterium logisch niet kan halen, wordt niet gered door een vlekkeloze uitvoering. Het is tegelijk de fase die het zwaarst op professional judgment leunt: de auditor moet beslissen of een beschrijving de doelstelling dekt, of de reikwijdte klopt, of het geheel navolgbaar genoeg is en wat er aan risico overblijft. Dat is minder zwart-wit dan het vaststellen of een reconciliatie correct is uitgevoerd, systeemback-ups tijdig zijn gemaakt en of een vierogenprincipe consistent is toegepast. Twee dingen lopen bij zo’n oordeel over de opzet makkelijk door elkaar, en het onderzoek scheidt ze bewust. Geeft het model bij herhaling hetzelfde antwoord? En klopt dat antwoord? Een model kan tien keer hetzelfde zeggen en tien keer fout zitten (zie ook het kader).
Onderzoeksopzet in het kort
-
Eén geanonimiseerd SOC 2 Type 2-rapport onder ISAE 3000 en de AICPA Trust Services Criteria.
-
56 criteria per beoordelingsronde: 33 Common Criteria, 18 Privacy Criteria, 3 Availability Criteria en 2 Confidentiality Criteria.
-
Model gpt-4.1-mini, snapshot van april 2025, via de API en niet via de chatinterface.
-
Korte context: een samenvatting van de organisatie, vijftig losse beoordelingsronden per criterium.
-
Lange context: de volledige systeembeschrijving, 36 beoordelingsronden per criterium.
-
Ruim 9000 beoordelingen in totaal, maar gebaseerd op 56 criteria in één rapport.
-
Expertpanel van vier auditors (één RA, drie seniors) als maatstaf voor de betrouwbaarheid.
-
Per ronde vastgelegd: promptversie en hash, modelversie, instellingen en de volledige uitvoer.
Instructie aan het model
Het belangrijkste onderdeel is de instructie aan het model. Die vertaalt de vraag: is deze opzet toereikend? naar vijf toetspunten. Dekt de maatregel het criterium, klopt de reikwijdte, is de procedure helder genoeg om te herhalen, is er documentatie om op terug te vallen, en blijft er een restrisico over? Die vijf zijn afgeleid uit terugkerende thema’s in de richtlijnen bij ISAE 3000, de Trust Services Criteria en Nederlandse literatuur over opzetbeoordeling van beheersmaatregelen. Het zijn geen voorgeschreven normen, maar een werkbare vertaling ervan. Per criterium geeft het model één oordeel (toereikend, deels toereikend, ontoereikend), een korte onderbouwing per toetspunt en een aanbeveling. Alles volgt in een vast format, zodat de antwoorden vergelijkbaar zijn en niet de ene keer een essay en de andere keer een opsomming opleveren.
Niets anders dan tekst
De belangrijkste keuze is dat het model niets anders ziet dan de tekst: het contextblok, het criterium en de daaraan gekoppelde beschrijvingen van beheersmaatregelen. Een compenserende maatregel die er wel is maar niet in de documentatie staat, telt niet mee. Dat is een onderzoeksmatige beperking en niet iets wat de standaard voorschrijft: in een echte opdracht wegen waarneming, gesprekken en walkthroughs juist wel mee. Wat hier is gemeten, is dus opzet zoals gedocumenteerd. Om te toetsen of het model werkelijk op de tekst reageert en niet op ruis, zijn de koppelingen tussen criteria en beheersmaatregelen bewust gemanipuleerd. Thematisch verwante tekst toevoegen die niet aan het criterium was gekoppeld, had geen effect. Het weghalen van één ongeldige verwijzing had wel effect.
Wat het onderzoek laat zien
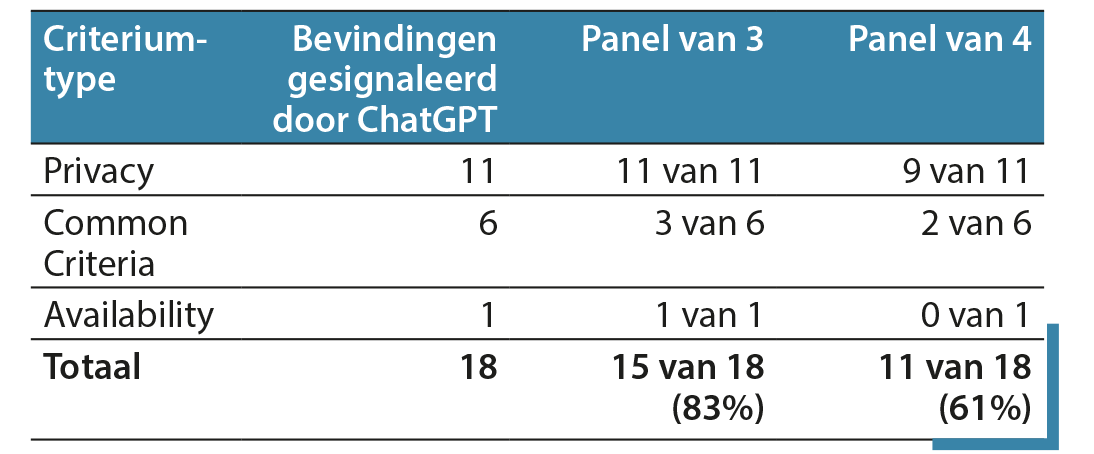
Het model bleek opvallend consistent: bij herhaalde beoordelingen kwam het vrijwel steeds tot hetzelfde oordeel. Van alle ronden bleven achttien tekortkomingen over die het model telkens opnieuw aanwees, en alleen die zijn aan het panel voorgelegd. De auditors verschilden onderling duidelijk vaker van mening. Dat laat zien dat ook menselijke beoordeling niet altijd eenduidig is. Van de achttien tekortkomingen die het model consequent aanwees, onderschreven drie auditors er vijftien. Met de vierde auditor erbij waren dat er elf (zie tabel 1). De uitkomsten moeten daarom niet worden gezien als een harde maatstaf voor ‘goed’ of ‘fout’, maar vooral als een aanwijzing waar nader onderzoek nodig is.
Opvallend is dat de meeste bevindingen niet wezen op een slecht ontworpen beheersmaatregel. Ze hadden vooral betrekking op de manier waarop die maatregel was beschreven. Informatie was bijvoorbeeld niet volledig, niet specifiek genoeg of onvoldoende duidelijk vastgelegd. Daarmee is de belangrijkste opbrengst breder dan alleen de inzet van AI. Het model kan vooral helpen om systeembeschrijvingen kritisch tegen het licht te houden en zichtbaar te maken waar de documentatie scherper en vollediger kan.
Over het hoofd zien
Wat niet is gemeten, is wat het model over het hoofd ziet. De bevindingen zijn getoetst, de toereikend-oordelen niet systematisch. Alle toereikend-oordelen zijn wel aan het panel voorgelegd met de vraag te melden wat opviel, en er kwam niets terug, maar zonder vastgelegde stemmen is dat hooguit een aanwijzing. Verder: één rapport, één taal, één rapportstijl, en het goedkoopste AI-model dat de klus aankon, omdat er duizenden ronden gedraaid moesten worden. Dat maakt de uitkomst eerder een ondergrens dan een bovengrens. Wat wel stevig lijkt te staan, is het gedrag van het model. Het model werkt als een behoedzame junior auditor. Het rekent niets mee wat niet is opgeschreven, het straft overbodige stappen niet af, en het wijst de plekken aan waar de beschrijving dun is.
Wat de auditor hiermee kan
Concreet krijgt de auditor met toepassing van AI bij de beoordeling van de opzet er een tweede lezer bij die nooit moe wordt en zich strikt aan de tekst houdt. De winst zit op drie punten. Ten eerste consistentie: waar twee ervaren collega’s over dezelfde opzet uiteenlopen, kwam het model bij herhaling vrijwel steeds tot hetzelfde oordeel. Dat maakt de beoordeling herhaalbaar en de onderbouwing navolgbaar. Ten tweede efficiëntie: alle criteria worden in één doorloop tegen hetzelfde kader gelegd zonder dat de aandacht verslapt bij het zestigste criterium. Ten derde, en dat is de kern, scherpte in de documentatie. De meeste bevindingen wezen niet op een slecht ontworpen beheersmaatregel, maar op een beschrijving die onvolledig, te vaag of niet herleidbaar was.
Daarmee is de opbrengst breder dan AI alleen. Het model werkt als een meetlat langs de eigen systeembeschrijvingen en maakt zichtbaar waar de vraag: staat het er echt, of weten wij het gewoon? onbeantwoord blijft. Wat het niet doet is zelfstandig oordelen: het levert signalen, geen conclusies. De auditor blijft degene die weegt, aanvult en beslist. De vijf tips in het kader vertalen dat naar de praktijk, ook voor wie zelf geen model inzet.
Vijf tips voor toepassing AI bij de beoordeling van opzet
-
Behandel een door AI gesignaleerde bevinding als een aandachtspunt of signaal, en niet direct als een tekortkoming. De vraag eronder is steeds dezelfde: is de beheersmaatregel expliciet genoeg beschreven? Op basis van de analyse van de bevinding kan dit leiden tot de conclusie dat de opzet van de beheersmaatregel alsnog toereikend is, of dat daadwerkelijk sprake is van een ontwerpgebrek.
-
Lees de reden van de gesignaleerde bevinding, niet het label. Het oordeel zelf zegt weinig, het betreffende toetspunt eronder wijst aan waar je op moet letten. Een bevinding op herleidbaarheid betekent dat er geen aanwijsbaar bewijsstuk is. Een bevinding op reikwijdte betekent dat onduidelijk is voor welke systemen of gebruikersgroepen de maatregel geldt. Dat zijn twee heel verschillende vervolgacties.
-
Werk in twee ronden. Ruim eerst ongeldige verwijzingen op (al helpt dat niet overal), voeg dan een criteriumspecifiek detail toe en beoordeel opnieuw. Bewaak de rolscheiding: wie de beschrijving aanscherpt, beoordeelt die daarna niet zelf.
-
Gebruik de vijf beschreven toetselementen ook als je geen model inzet. Beschouw of de maatregel het criterium dekt, of de reikwijdte klopt, of de procedure helder genoeg is om consistent te herhalen, of er documentatie is om op terug te vallen, en of er nog een restrisico overblijft. Dat is waar het model stelselmatig op viel, en het werkt net zo goed als een leesbril bij een reviewronde op je eigen systeembeschrijving. Hier zit de winst voor iedere auditor, ook voor wie nooit met AI werkt.
-
Zet je AI wél in: gebruik dan een afgeschermde, kantoorinterne omgeving, geen publieke chatinterface. Voed die alleen met eigen, vastgestelde bronnen (SOC 2-voorbeelden, methodiek, begrippenlijst). Werk met vaste instellingen en een genummerde prompt, en bewaar prompt, context en uitvoer in het dossier. Test na elke modelwijziging een paar criteria met bekende uitkomsten, om te zien of je opstelling nog hetzelfde oplevert.
Over
Max Külbs is compliance- en auditconsultant. In het kader van zijn opleiding Executive Program of Digital Auditing aan de Universiteit van Amsterdam onderzocht hij of AI kan helpen bij de beoordeling van de opzet van beheersmaatregelen.
Reacties (0)
Lees meer over dit onderwerp:
Een AI-handvat voor de IA
Met de komst van artificial intelligence (AI) krijgen we ook te maken met AI-risico’s. De vraag is hoe we hier als internal auditors mee om moeten gaan.
Lees meerWaarderend auditen: vernieuwende positieve invalshoek
Wij als traditionele auditors zijn opgeleid in het opsporen van risico’s en tekortkomingen. Maar hoe vaak halen wij positieve beelden op en rapporteren wij hierover?
Lees meer
Wilt u ook een reactie plaatsen?
Voor het plaatsen van een reactie vereisen wij dat u bent ingelogd. Heeft u nog geen account? Registreer u dan nu. Wilt u meer informatie over deze vereiste? Lees dan ons privacyreglement.